


Funktsionaalsete programmide ja matemaatiliste tõestuste vahelist seost kutsutakse Haskell Curry ja William Alvin Howardi järgi Curry-Howard’i vastavuseks. Vastavus tuleneb struktuursetest sarnasusest formaalsete loogikate ja tüübisüsteemi abil kirja pandud arvutusmudelite vahel.
Hiljem vaatame, mida saame üle kanda programmeerimisest loogikasse ja loogikast programmeerimisse.
Oleme juba vaadanud üht näidet tüübisüsteemist: lihtsalt tüübitud λ-arvutust. Nüüd vaatame lausearvutust ja paneme tähele sarnasusi tüübisüsteemiga. Sarnased lauserarvutuse definitsioonid on olnud Tartu Ülikooli kursustes Loogika arvutiteaduses ja Diskreetne matemaatika I.
Gentzen-i stiilis loomulikus tuletuses kasutatakse otsusteks sekventse on kujul: Γ ⊢ P, kus P on loogika valem ja Γ on kontekst ehk (kohalike) hüpoteeside hulk.
Sõltumata valemist kehtib hüpoteesi aksioom, mis ütleb et kontekstis olevad väited on tõesed. Pane tähele, tegemist on lihtsa tautoloogiaga: kui eeldame P, siis saame väita P.

Tihti algab arutelu küsimusega, kas valem P kehtib ilma hüpoteesideta ehk tühjas kontekstis. S.t. proovime tõestada väidet ⊢ P.
Loomuliku tuletuse iga konnektiiviga (∧, ∨, ⊃, …) on seotud kaht liiki reegleid: sissetoomise reeglid ja väljaviimise reeglid. Sissetoomise reeglites esineb konnektiiv järelduses ja vastab küsimusele: ”kuidas näidata konnektiiviga väite tõesust”. Väljaviimise reeglid esineb konnektiiv eelduses ja vastab küsimusele: ”kuidas kasutada konnektiiviga väidet”.
Edasi näitame vajalike konnektiivide (P ⊃ P ∣ P ∧ P ∣ P ∨ P ∣ ⊤ ∣ ⊥ ∣ ¬ P) sissetoomise ja väljaviimise reegleid. Alustame implikatsiooniga P ⊃ P.
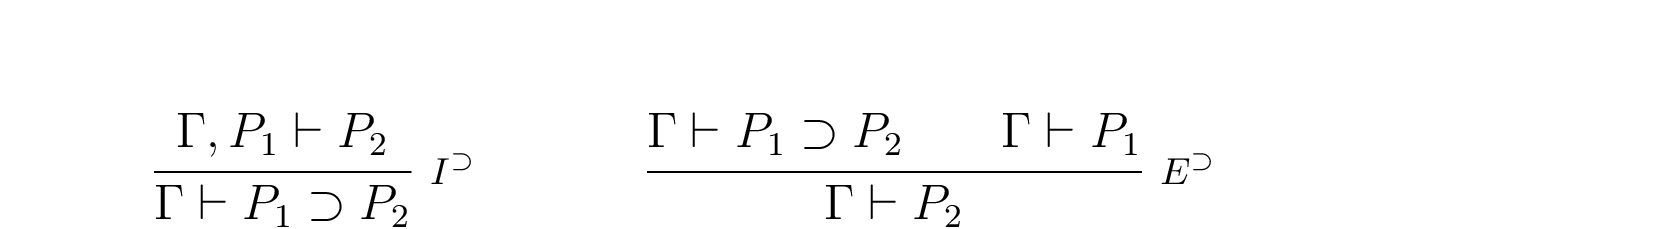
Tuletusreegleid saab lugeda alt-üles kui ka ülevalt-alla. Kumb lugemise viis intuitiivsem tundub, on enamasti subjektiivne. Näiteks alt-üles: selleks, et näidata implikatsiooni P1 ⊃ P2 kehtimist kontekstis Γ, piisab näidata valemi P2 kehtimist kontekstis Γ, P1. Või siis ülevalt-alla: kui kehtib väide P2 kontekstis Γ, P1, siis kehtib implikatsioon P1 ⊃ P2 kontekstis Γ. Seega, alati on võimalik reegel tekstis formuleerida mõlemat pidi ja edaspidi me õpikus ei kirjuta mõlemat versiooni välja. Seega, implikatsiooni väljaviimise reegel väidab, et kui kehtivad nii implikatsioon P1 ⊃ P2 ja valem P1 kontekstis Γ, siis kehtib ka valem P2 kontektis kamma.
Sarnaselt implikatsioonile saab anda reeglid konjunktsiooni ja disjunktsiooni jaoks.
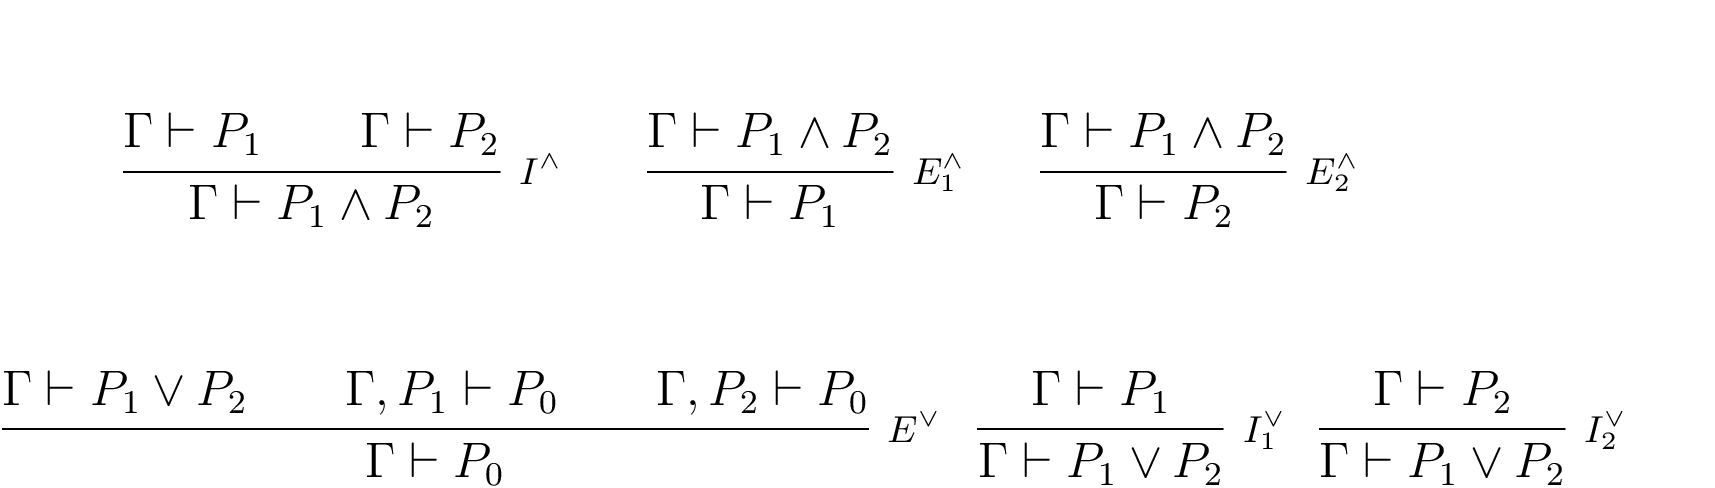
Pange tähele, et konjunktsioon ja disjunktsioon on mingis mõttes duaalsed: konjunktsioonil kaks väljaviimise reeglit on sarnased disjunktsiooni sissetoomise reeglitega, kui vahetada eeldused ja järeldused.
Samasugune sarnasus on tegelikult ka konjunktsiooni sissetoomise ja disjunktsiooni väljaviimise reegli vahel. Kuna aga järeldusi võib olla vaid üks, siis tuleb disjunktsiooni väljaviimise reegli jaoks teha lisatööd: kahe järelduse asemel tuleb eeldada, et mõlemast järeldusest järeldub omakorda ühine P0.
Järgmisena vaatame tüüpimisreegleid samaselt tõese väite ⊤ ja samaselt väära väite ⊥ kohta. Samaselt tõesel väitel ⊤ on ainult sissetoomise reegel ja samaselt vääral ⊥vaid väljaviimise reegel. Seetõttu, väidet ⊤ on sissetoomise reegilga triviaalne tõestada aga väidet ⊥ ei ole võimalik tõestada, kuna sissetoomise reeglit ei olegi.
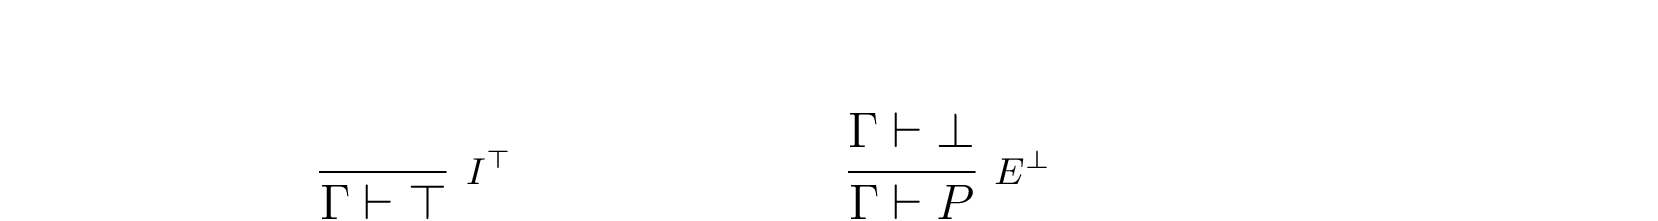
Pane tähele, et samaselt tõesel väitel pole väljaviimise reeglit. Seda polegi vaja, kuna hüpotees ⊤ ei kanna mingit informatsiooni ja seega samaselt tõesusest järeldamine ei anna midagi juurde. Mingit kasu me selise reegli lisamisest ei saaks.
Seevastu, kõige huvitavam nendest reeglitest on vääruse väljaviimine. Kui me oleme jõudnud sellisesse absurdsesse olukorda, kus kontekstis Γ on tõestatav ⊥, siis on kontekstis Γ kõik väited P tõestatavad.
Kasutades väärust ⊥ saame defineerida eituse süntaktilise suhkruna kui ¬ P ≡ P ⊃ ⊥.
Kirjeldatud reeglid annavad intuitsionistliku lausearvutuse IPC. Sõna intuitsionistlik tähendab loogikas seda, et loogika tuleneb konstruktiivsest mõttetegevusest ja mitte objektiivse reaalsuse reeglite avastamisest. Ehk siis tõde on vaid see, mida me saame tõestada. Me ei saa maailmas avastada tõde — ei saa juhtuda olukorda, et mingi asi on tõde aga me ei saa aru, miks see on tõde.
Intuitsionistlikule loogikale vastandub nn. klassikaline loogika, kus kehtib reegel, et iga väide on kas tõene või väär. Seda nimetatakse ka välistatud kolmanda reegliks. Ehk siis klassikalises loogikas kehtib väide A∨ ¬ A. Sama väide ei kehti intuitsionistlikus loogikas, kui me ei tea, kas väide A on tõene või mitte.
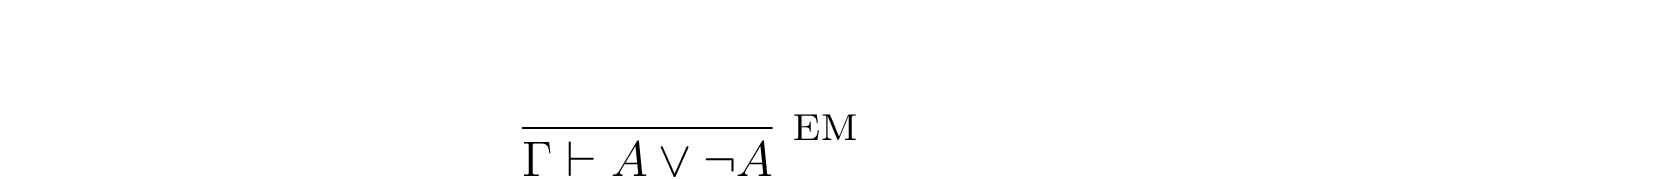
Klassikalise loogika saame, kui IPC reeglitele lisame välistatud kolmanda reegeli või sellele samaväärse kahekordse eituse elimineerimise reegeli.
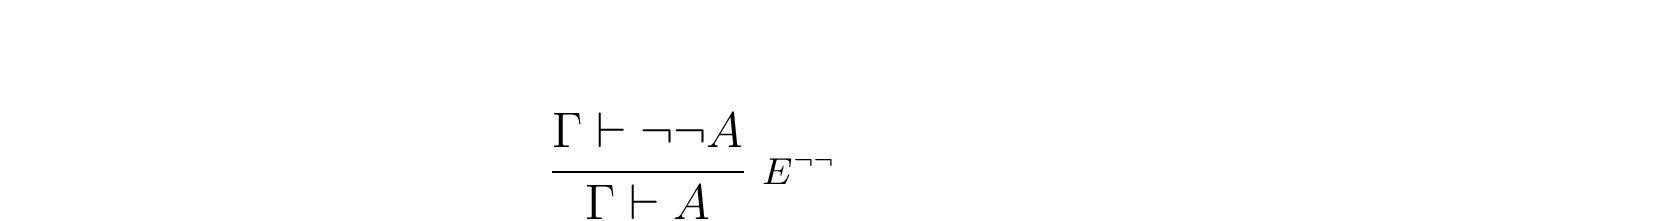
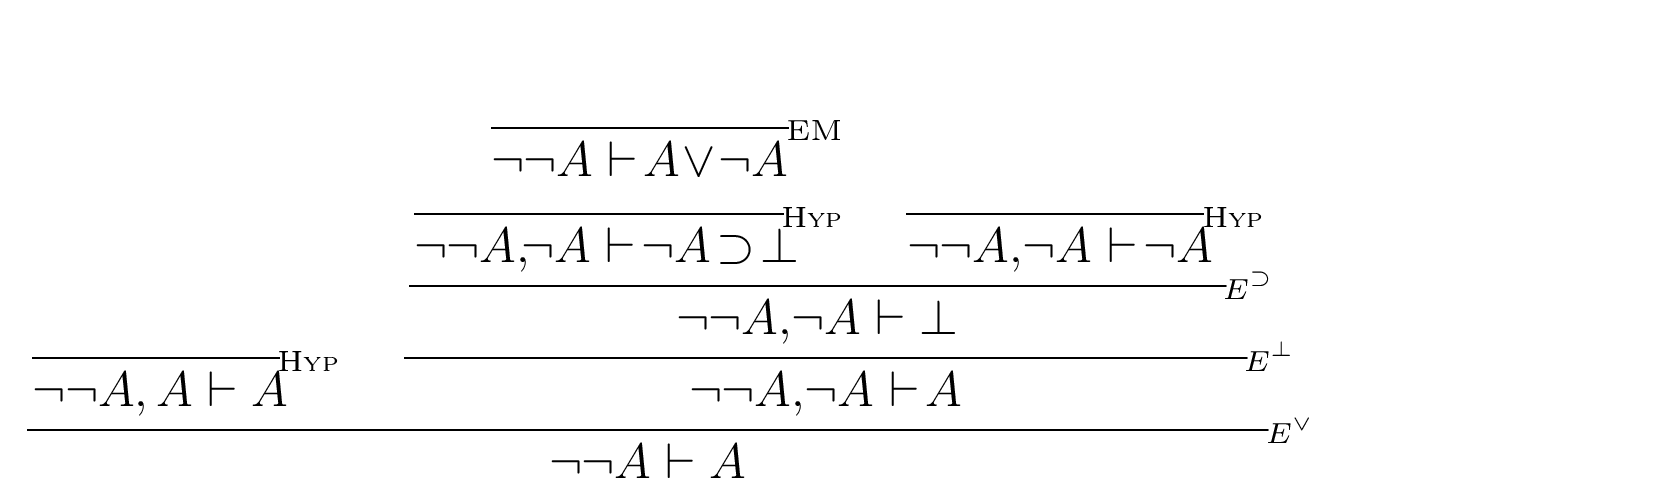
Järgnevalt tõestame, et välistatud kolmanda reeglit kasutades saame tõestada kahekordse eituse elimineerimise. Selleks piisab näidata, et kehtib ¬¬ A⊢ A ilma reeglit E¬¬ kasutamata. Järgneb tõestuspuu.
Järgnevalt tõestame, et kahekordse eituse elimineerimist kasutades saame tõestada välistatud kolmanda reeglit. Selleks piisab näidata, et kehtib ⊢ A∨ ¬ A ilma reeglit EM kasutamata.

Paneme tähele süntaktilisi sarnasusi vastavate konstruktsioonide ja reeglite vahel. Näiteks Abs ja I⊂ reeglid, App ja E⊂ reeglid ning Var ja Hyp reeglid. Kusjuures, loogikas pole “programm” (alati) ilmutatud kujul välja toodud, aga saame selle rekonstrueerida tõestuspuu järgi. Ehk näeme, et implikatsioonile loogikas vastab funktsioonitüüp tüübitud λ-arvutuses.

Sarnaselt eelnevatele vastab konjunktsioonile tüüpide korrutis (ehk paar), disjunktsioonile tüüpide summa ning tõesusele ühiktüüp. Väärusele vastavat konstruktsiooni me veel defineerinud ei ole aga konstantide abil saame defineerida tüübi False ja konstandid absurdA : False → A iga tüübi A jaoks. Pane tähele, et kuna tüübi False jaoks konstruktoreid pole, siis sellist tüüpi väärtust teha võimalik ei ole.
Millest tuleneb aga erinevus, et loogikas pole “programme” aga λ-arvutuses on? Korrektselt tüübitud termid lihtsalt tüübitud λ-arvutuses vastavad tüübikontrolli puule. Seega, miks pole loogikas puule vastavat kodeeringut? Vastus: kuna programmis on tähtis, kumb parameeter tagastada, kuid loogikas pole tähtsust kumma eelduse põhjal midagi järeldatakse. Aga tehniliselt saame loogikat siltidega täiendada — jälgimaks, millisest implikatsioonist aksioom tuleneb.
Järgmisena vaatame, mis on reduktsioonile vastav mehhanism. Meenutame, et β-reduktsiooni reegel oli (λx : τ. e1) e2 →β e1[x→e2]. Ehk siis viime implikatsiooni välja kohe peale selle sisse toomist. Saame järgneva sammu loogikas.
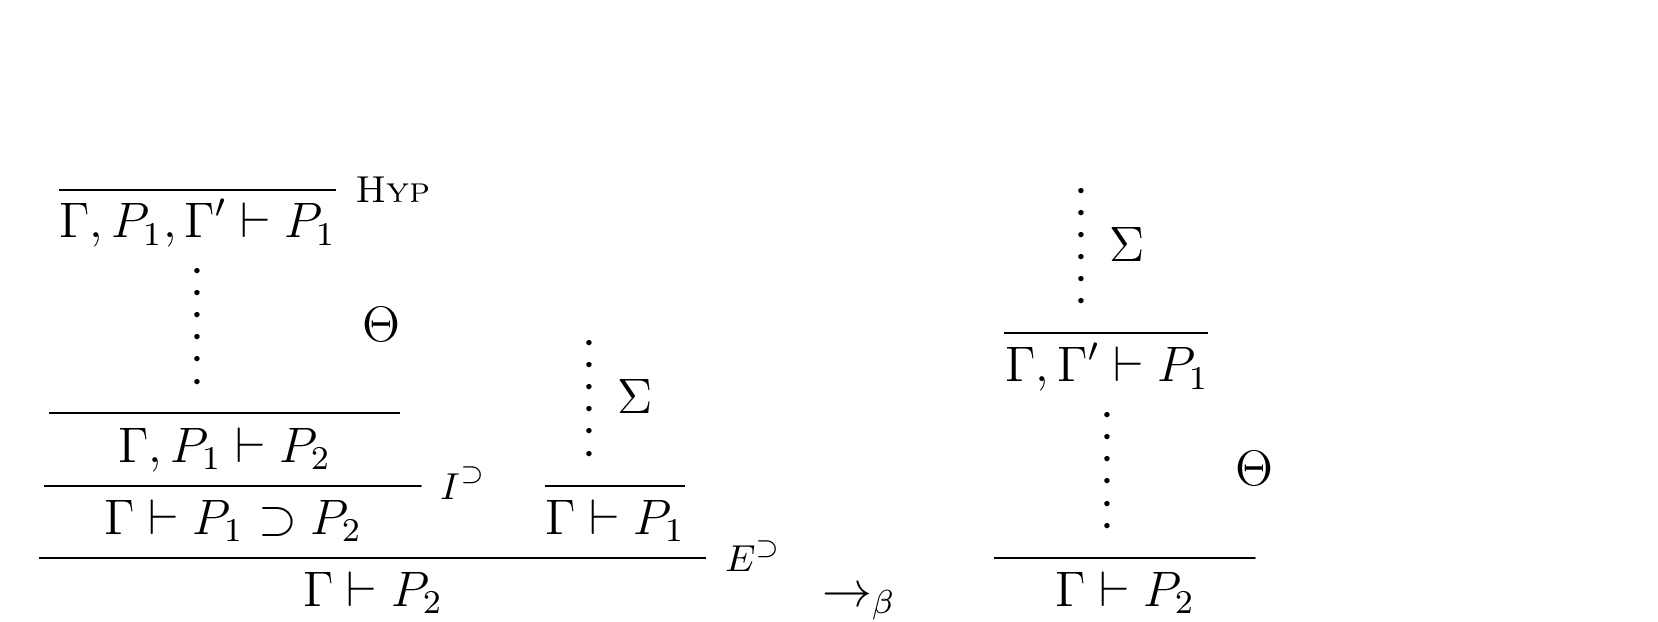
Paneme tähele, et Γ, P1 ⊢ P2 tõestuses saame teha kõike mis Γ ⊢ P2 ning lisaks kasutada hüpoteese Γ, P1, Γ′ ⊢ P1 iga Γ′ jaoks. Aga kuna näeme puus Σ, et P1 tõestamiseks piisab kontekstist Γ, siis saab seda tõestada ka kontekstis Γ, Γ′. Seega kui meil on vasakule puule vastav tõestuspuu, siis saame selle abil genereerida valiidse paremale puule vastava tõestuspuu.
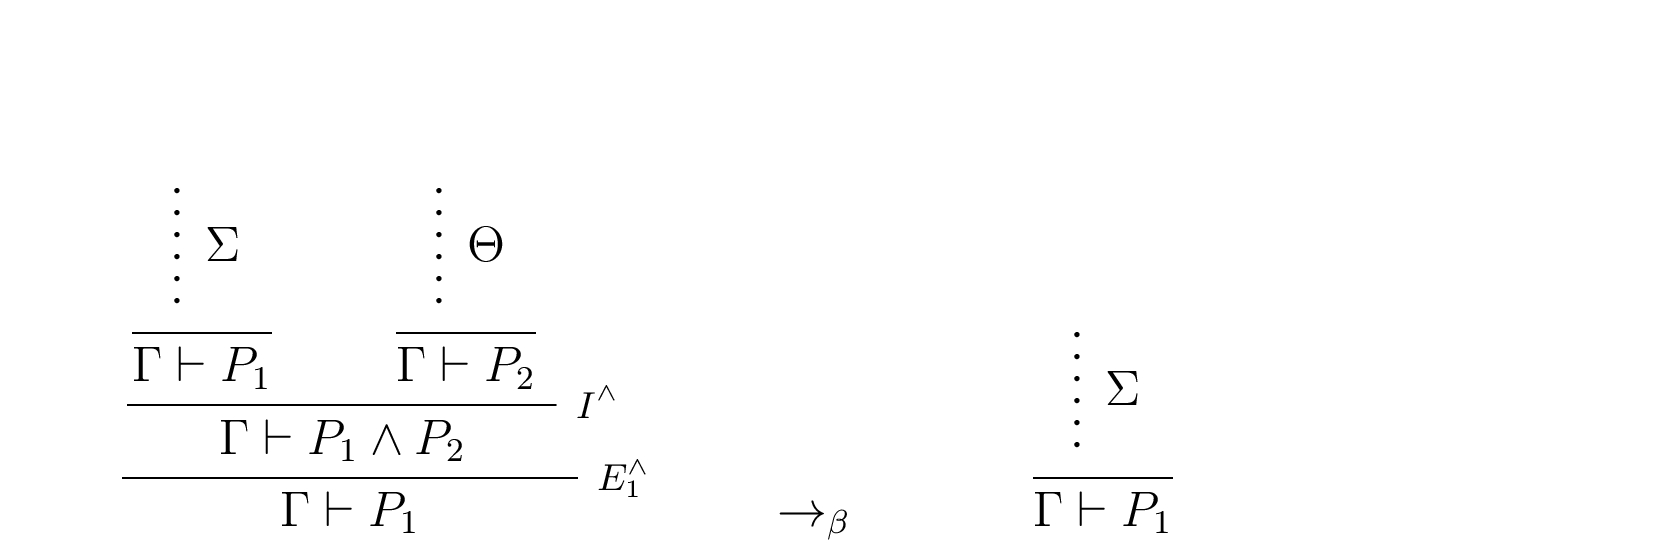
Sarnaselt implikatsiooni sissetoomise ja kohese väljaviimise redutseerimisele (β-reduktsiooni vaste) saame defineerida teiste konnektiivide sissetoomise ja väljaviimise reduktsioonid (δ-reduktsioonide vasted). Näiteks toome vaid konjunktsiooni vasaku väljaviimise reeglile vastava redutkstiooni
Kokkuvõtteks paistab, et tüübisüsteemidel ja loogikatel pole sisulisi erinevusi – see ongi Curry-Howard’i vastavus. Vaata järgnevat tabelit.
| Intuitsionistlik loogika | Tüübitud λ-arvutus |
| Väide | Tüüp |
| Lausemuutuja | Tüübimuutuja |
| Tõestus | Term |
| Hüpotees | Termi muutuja |
| Loogikatehe | Tüübikonstruktor |
| Tõestatavus | Vastavat tüüpi termi leidumine |
| Tõestuse normaliseerimine | Reduktioon |
See tähendab, et iga loogika on tüübisüsteemina kirja pandud arvutusmudel ja iga tüübisüsteemina kirja pandud arvutusmudel on loogika. Meelde tuleb aga jätta, et mitte iga kirjapandav loogika ega arvutusmudel pole kasulik. Järgnevalt vaatamegi neid mittekasulikke juhte.
Näiteks võib tüübisüsteem olla selline, et ainsaks baastüübiks on *. Tulemuseks on tüübisüsteem, mis väga suures osas vastab tüüpimata λ-arvutusele, kus välistatakse vaid olukorrad, kus rakenduse funktsioonikomponent pole tegelikult funktsioon. Sellist tüübisüsteemi tähistatakse näiteks λ*→ või ka λτ. Kuigi tüübisüsteem võib olla praktikas kasuliks, siis ei ole selle abil võimalik kodeerida huvitavaid väiteid ega nende tõestusi. Ehk, kõik kirjapandavad väited on triviaalselt tõestatavad ja seega ei saa nendest tõestustes midagi uut järeldada.
Järgmine näide on tüübisüsteemist, millel on sisseeehitatud püsipunktikombinaator. Seega suvalise tüübi jaoks saame luua mittetermineeruva vastavat tüüpi programmi. Kuigi programmeerijad on sellega rahul siis loogikud ei aktsepteeri lõpmatuid või mittetermineeruvaid tõestusi.
Loogikud kirtsutavad nina ka praktiliste tüübisüsteemide, nagu näiteks Java, peale. Need tüübisüsteemid on põhjendamatult keerukad loogikana kasutamiseks.
Aga võime vaadata ka teises suunas. Klassikaline loogika (näiteks klassikaline predikaatloogika) on kasutuses ja mitmete probleemide lahendamiseks täiesti sobilik tööriist. Samas, sellele vastavas tüübisüsteemis pole kolmanda välistava reeglile (või topelt eituse elimineerimise reeglile) vastavat funktsiooni definitsiooni — reduktsioon võib sellises süsteemis kinni jääda.
Viimase näitena võtame relevantsusloogikaid, kus on lubatud vaid implikatsioonid a⊃ b kui b tõestamiseks läheb a-d vaja. Selline nõue on aga programmeerijatele enamasti liiga kitsendav, kuna pole, näiteks, tüübidav funktsioon λx y. x. Samas on sellised kitsendused kasutuses näiteks kvantarvutustes, kus väärtusi ei saa piiramatult kopeerida ega minema visata.
Eelmises peatükis nägime, et igale tüübisüsteemile vastab loogika. Nüüd uurime, mis on Idris 2 keelele vastav loogika ning kuidas selles tõestusi teha saab.
Tõestamise aluseks on puhtad, täielikud funktsioonid. Kui programmeerijale on antud võimalus jääda lõpmatusse tsükklisse või lõpetada programmi töö erindiga, siis pole meil vajalikku garantiid, et eeldusest järeldub järeldus. See on ka põhjus, miks paljusid praktilisi programmeerimiskeeli ei saa kasutada tõestamiseks. Seevastu, Idris toetab puhtaid ja täielikke funktsioone.
Suurim erinevus Curry-Howardi vastavuse teoreetilise käsitluse ja selle rakendusel Idrises on kontekstide käsituluses. Teoorias saime kontekstide üle ise otsustada defineerides oma suva järgi kontekstidega tegelevaid reegleid. Idrises on kontekste muutvad reeglid sisse-ehitatud ja järgnevate reeglite lisamine käib viisil, kus kontekstid ei muutu.
Esmalt vaatame sisseehitatud reegleid, kus otsustes on kontekstid. Need reeglid on Idrise loogika peamiseks tööriistaks – funktsioonitüüp a -> b ehk täpsemalt (x : a) -> b.
Funktsioonitüübile vastab loogikas implikatsioon. Sõltuvaid tüüpe võimaldavale funktsioonitüübile (x : a) -> b vastab aga hoopis predikaatloogika üldsuskvantor ∀ x∈ A. B
Üldsuskvantori väljaviimise ehk funktsioonirakenduse reegel, nimetame seda näiteks E→, võtab avaldised f : (x: a) -> b ja e : a ning järeldab nendest f e : b[x->e]. Seda kõike iga konteksti Γ jaoks.

Idrises pole sellel reeglil tegelikut eraldi nime — saame sellele viidata kui funktsioonirakenduse termile f e vastavale reeglile.
Teine sisseehitatud reegel on üldsuskvantori ehk funktsiooni sissetoomise reegel, mida võime nimetada I→. Reeglist näeme, kuidas skoobis olevad funktsiooniparameetrid koos oma tüüpidega satuvad konteksti.

Ülejäänud sisulised reeglid saame luua andmestruktuuride loomise abil, kus sissetoomise reeglid tulevad konstruktorite tüübist ja väljaviimise reeglid vastava struktuuri mustrisobitusest.
Nägime, et loogikareeglitel on eeldused ja järeldus. Ning ka seda, et (mitme parameetriga) funktsioonil on eeldus(ed) ja järeldus. Seetõttu võime tänu sellele reeglile funktsioonist f tüübiga T1 → T2 → … → Tn → Tr mõelda kui reeglist

ehk
Järgnevalt vaatame, kuidas defineerida konnektiivid: konjunktsioon, disjunktsioon, tõesus, väärsus ja eituse. Samas tuletame meelde, mis tüüpi väärtusi defineerivad andmestruktuurid nagu paarid, tüüpide summad jne.
Konjunktsiooni defineerimiseks andmestruktuurina, peame konstruktoriks võtma konjunktsiooni sissetoomise reegli. Väljaviimise reeglile vastav tõestus tuleneb mustrisobituse avaldisest.

Pane tähele, et loodud konjunktsiooni andmestruktuurile on sisuliselt sama mis paari andmestruktuur Idrise standardteegis.

Disjunktsiooni defineerimiseks andmestruktuurina, peame konstruktoriks võtma mõlemad disjunktsiooni sissetoomise reeglid. Väljaviimise reeglile vastav tõestus tuleneb jälle mustrisobituse avaldisest.

Pane tähele, et loodud konjunktsiooni andmestruktuurile on sisuliselt sama mis Idrise standardteegis olev Either.

Tõesuse ja vääruse saame sammuti ise defineerida. Aga ka need on juba Idrise standardteegis olemas. Tõesusele vastab tüüp Unit ehk (), millel on konstruktor MkUnit ehk (). Väärusele vastab tüüp Void, millel konstruktorid puuduvad. Tüübil Void on aga vääruse väljaviimisele vastav funktsioon absurdity.

Nagu konstruktiivsele loogikas tavaks, saab eituse konnektiivi defineerida läbi implikatsiooni väärusesse. Seega oleme katnud lausearvutuse osa. Aga nägime ka, et väärtusest sõltuv funktsioonitüüp on üldsuskvantor. See tähendab, et predikaatloogikast on puudu vaid olemasolukvantor. Selline struktuur on standardteegi moodulis Data.DPair.
Näiteks saame võtta väite, et leiduvad viiest suuremad naturaalarvud. Sellist väidet kodeerib näiteks Idrise tüüp
Exists (\ x: Nat. x>5 = True). Selle väite tõestamiseks peame pakkuma välja mingi arvu y ja siis näitama, et kehtib y>5 = True. Näiteks on sobiv arv 6 ja sellele vastav tõestus Refl. Ehk saame kirjutada järgnevalt.
| 1bigNum : Exists (\x:Nat => x>5 = True) 2bigNum = Evidence 6 Refl |
Esiteks paneme tähele, et jällegi on sarnasus paaridega: tüübil on üks konstruktor, millel on kaks argumenti. Lisaks, andmestruktuuril on väljad fst ja snd. Aga erinevalt tavalistest paaridest on tegemist sõltuvate paaridega, kus paari esimese komponendi valik kitsendab, mida teise komponendina saab kasutada. Selliseid sõltuvaid paare saame kasutada ka paaride implementatsioonina. Vaata järgmist koodilõiku.
| 1myPair : Type -> Type -> Type 2myPair a b = Exists (\x:a => b) 3 4test : myPair Char String 5test = Evidence 'x' "Hello!" |
Seega, kui tingimus parameetrist ei sõltu, saame tavalise paari. Siiski leidub erinevus paaride ja selle olemasolukvantori implementatsiooni vahel. Nimelt, Exists on mõeldud tõestuste kirjutamiseks ja seetõttu on paari esimene komponenti lubatud kasutada vaid tüübikontrolli ajal. Programmi käivitamise ajaks on paari esimese komponent unustatud.
| Main> test.snd "Hello!" Main> test.fst Error: ... |
Tänu eelmainitud Curry-Howard’i vastavusele on puhas tüübisüsteem sobilik alus tõestamis- ja loogikasüsteemidele. Samas ei ole Idris 2 kõige parem keel, millega formaalseid tõestusi läbi viia.
Üks suur probleem on see, et Idris 2’s on väärtuse Type tüüp samuti Type. See on lihtsaim lahenus küsimusele, et mis on siis Type-i tüüp. Jean Yves Girard tõestas aga aastal 1972, et sellised süsteemid on vastuolulised. See n.n. Girard’i paradoks on ka põhjus, miks Martin-Löf pidi oma tüübiteooria hilisemates versioonides kasutusele võtma hoopis keerukama tüübiuniversumite hierarhia Type0 : Type1 : Type2 : ….
Seega on Idris2-s võimalik mõnekümne koodireaga anda tõestus väitele False ning seeläbi tõestada suvaline loogiline väide. Järelikult tuleks tõsisemaks formaalseks tõestuseks võtta ka süsteem, kus poleks Type : Type vaid näiteks lõpmatu universumite hierarhia.
Järgnevalt vaatame näiteid tõestuste süsteemidest Rocq, Lean4 ja Agda.
Rocq tõestaja, varem tuntud kui Coq tõestusassistent, sai alguse 1989 aastast kui Thierry Coquand’i tüübiteooria Calculus of constructions (CoC) implementatsioon. Sellest ajast saadik on nii teooriat kui implementatsiooni täiendatud.
Kuigi Rocq on tüübiteooria süsteem, saab seda kasutada interaktiivse tõestuskeskkonnana. Tõestuseid ei kirjutata enamasti otse programmina vaid kasutatakse n.n. tõestuse taktikaid, näiteks reflexivity, induction, simpl, rewrite, ja lia. Lisaks, saab faili läbimisel peatuda taktikate ja definitsioonide vahel ning vaadata jooksva tõestuse eesmärki (paremal, joone all) ning tõestuse hüpoteese (paremal, joone peal). Vaata järgnevat kuvatõmmist Rocq-is tõestamisest.
Näitena toodud koodis defineeritakse rekursiivne funktsioon fac, mis võtab ühe argumendi n ja teeb sellel mustrisobitust. Juhul, kui parameeter on null, tagastab funktsioon arvu üks. Juhul, kui naturaalarv on ühe võrra suurem n'-st, siis korrutatakse parameeter rekursiivse väljakutse tulemuse ehk fac n'-ga. Järgnevad kaks lemmat nimedega fac_succ
ja fac_pos.
Lemma fac_succ väidab, et iga n-i jaoks kehtib võrdus fac (S n) = S n * fac n ehk fac (1+n) = (1+n)*fac(n). Selle võrduse kehtimiseks piisab võrduse mõlema poole lihtsustamisest ja refleksiivsuse aksioomi kasutamisest — taktika reflexivity teeb mõlemat korraga.
Lemma fac_pos väidab, et iga n-i jaoks kehtib võrdus fac n > 0 ehk funktsioon tagastab iga naturaalarvu jaoks nullist rangelt suurema väärtuse. Tõestus käib induktsiooniga üle parameetri n, mille tõttu hargneb tõestuseesmärk kaheks. Esimese haru (kus n=0) tõestamise esimene samm on funktsioonikutse fac 0 lihtsustamine. Ehk siis taktika simpl tõttu on haru eesmärgiks 1 > 0, mida suudab tõestada lineaarse täisarvu aritmeetika tõestamise taktika lia. Teises harus on vaja tõestada induktsiooni samm: et hüpoteesist fac n > 0 järeldada eesmärk fac (S n) > 0. Eesmärk kirjutatakse lemma fac_succ järgi ümber eesmärgiks S n * fac n > 0. Täpselt sellest seisust on ka kuvatõmmis. Jäänud eesmärgi suudab tõestada lineaarse täisarvu aritmeetika tõestamise taktika lia.
Rocq-ile väga sarnane süsteem on
Even: Nat -> Type ja Odd: Nat -> Type ning tõestage vähemalt plusEvenEven, plusOddOdd ja plusEvenOdd.